모델 실험: 개별 학습과 공동 학습
1. 실험 범위와 지표
아래 Residual Geo GNN은 12,000 요청 노드의 CAD 위험 전용 모델이며, 실제 노드는 AC28 11,956, ME1a 12,324입니다. 이는 5k 문맥 입력 계약을 쓰는 다중해상도 모델이 아닙니다. AP, IoU@0.5, Dice@0.5는 CSV 결함점에서 만든 약한 라벨을 같은 실행에서 평가한 진단값입니다. production_valid는 모두 false입니다.
2. AC28 개별 · ME1a 개별 결과
| 대상 | 학습 실행 | AP | IoU@0.5 | Dice@0.5 | 약한 양성 노드 |
|---|---|---|---|---|---|
| AC28 16h | AC28 16h 단독 | 0.3849 | 0.2000 | 0.3333 | 9 |
| AC28 18h01 | AC28 18h01 단독 | 0.4455 | 0.1364 | 0.2400 | 21 |
| ME1a 14h06 | ME1a 14h06 단독 | 0.6292 | 0.4762 | 0.6452 | 13 |
ME1a의 0.6292 AP / 0.4762 IoU는 현 개별 약한 라벨 진단에서 가장 높은 최적화 모델 수치입니다. 표본 하나에 맞춘 값이므로 다른 제품 또는 공정에서 재현될 것으로 해석할 수 없습니다.
ME1a 0.6292 / 0.4762 / 0.6452는 어떻게 나왔나
이 값은 ME1a 14h06 한 run을 학습하고 같은 run에서 평가한 12k Residual Geo GNN의 mapped AP / IoU@0.5 / Dice@0.5입니다. 실행 기록상 12,324개 실제 그래프 노드 중 약한 양성은 13개였고, 180 epoch 학습에서 별도 검증셋이 아닌 학습 손실의 최저값 0.4774를 기록한 epoch 170 체크포인트가 선택되었습니다. 임계값 0.5에서 fine graph의 예측 양성은 18개, top-k recall은 0.6923입니다. 실제 약한 양성 13개 중 10개를 맞춰 TP 10, FP 8, FN 3이므로 IoU는 10/(10+8+3)=0.4762, Dice는 20/(20+8+3)=0.6452입니다. AP 0.6292는 이 임계값의 비율이 아니라 모든 노드 확률 순위의 평균정밀도입니다.
코드상 이 최적화 실험은 10 mm 지오데식 CSV-anchor 영역을 hard binary 약한 타깃으로 사용하고, 실행별 class-balanced BCE(양성 가중치 상한 1,000)와 soft Dice loss를 합칩니다. 모델은 정규화한 노드 특성·유효성 마스크, edge 특성, 공정/형상 전역 특성, CAD 좌표의 Fourier feature를 사용하며 2단계 residual edge message passing을 합니다. AdamW(lr 0.003, weight decay 1e-5)를 사용합니다.
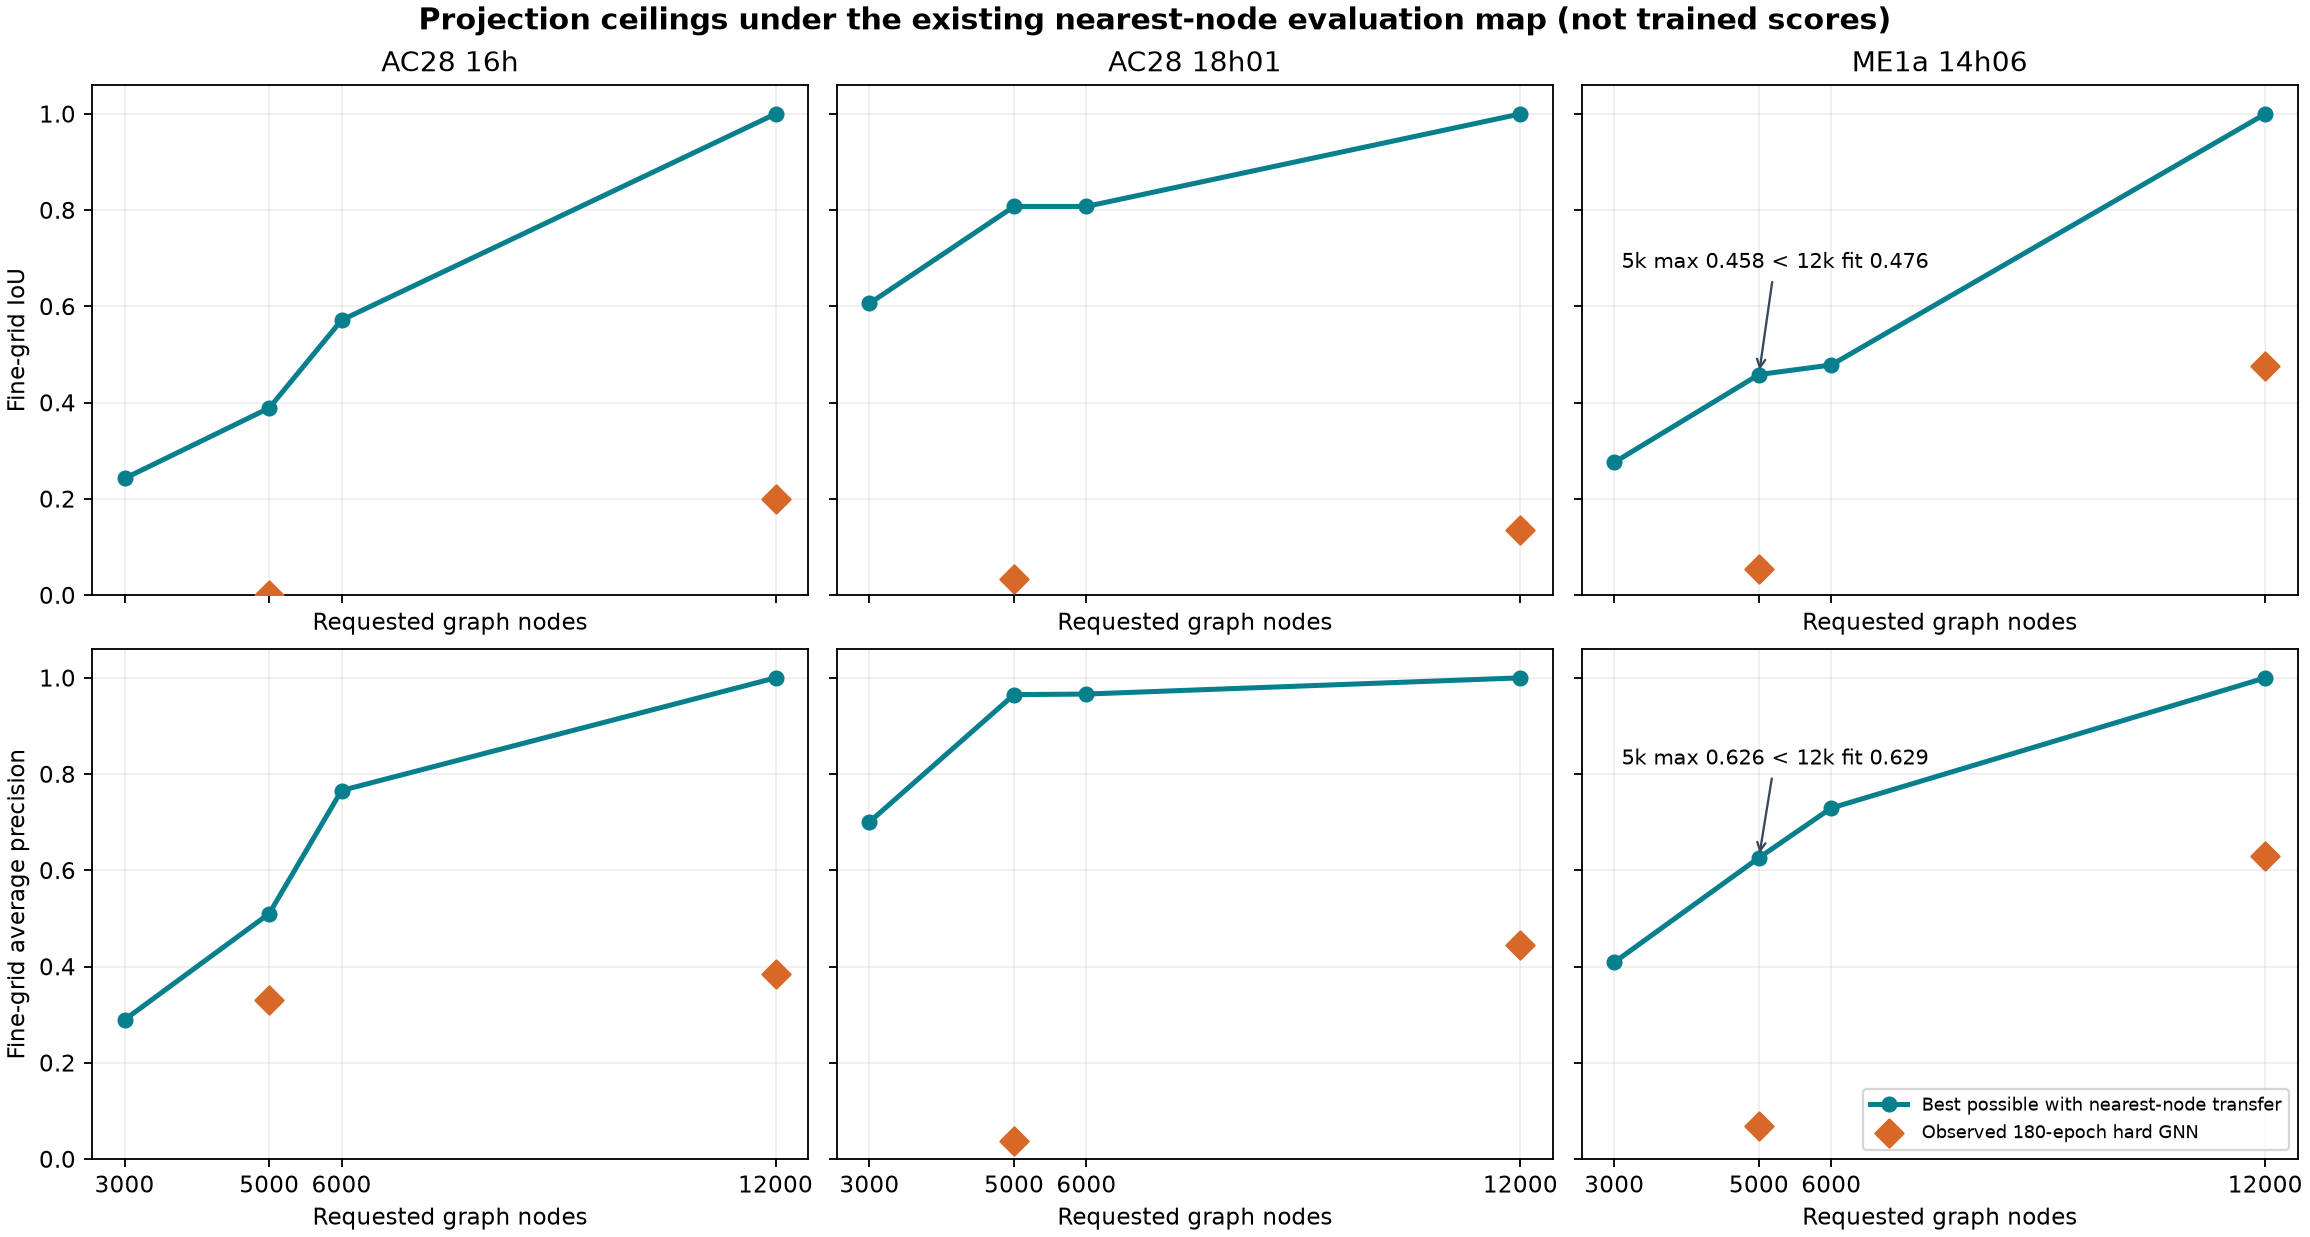
12k는 해당 약한 영역을 finest graph에서 직접 평가하므로 label-transfer IoU가 1.0입니다. 5k의 ME1a 개별 hard 진단은 AP 0.0685 / IoU 0.0547 / Dice 0.1037이었고, fine label transfer IoU도 0.175입니다. 5k와 12k 비교는 같은 run·모델·hard loss·180 epoch를 사용했습니다. 달라진 그래프 예산은 노드 배치와 10 mm 약한 마스크를 함께 바꿉니다. 5k의 label-transfer IoU 0.175는 작은 약한 영역이 격자에서 손실됨을 보여 줍니다. 다만 노드 배치, 타깃 변화, 최적화 효과를 분리한 ablation은 없으므로 특정 요소 하나를 상승의 원인으로 확정하거나 일반화 향상을 주장할 수 없습니다.
비교 기준도 다릅니다. ME1a 기존 FNO2d는 AP 0.4438 / IoU 0.1429, 기존 2D CNN/U-Net은 0.2978 / 0.1429였지만 입력 표현·학습 설정이 달라 공정한 원인 비교가 아닙니다. 공동 12k 학습에서는 ME1a 값이 AP 0.4765 / IoU 0.0535로 내려갔고, ME1a를 제외한 held-out 12k 학습에서는 AP 0.0010 / IoU 0 / Dice 0이었습니다. 즉 0.6292는 same-run 약한 라벨 적합도이며, 새 run 예측 근거는 아닙니다.
근거: models/gnn_joint_experiment.py · optimized 12k CSV · 5k vs 12k CSV · baseline comparison CSV.
3. AC28 + ME1a 3-run 공동 학습
공동 모델은 AC28 16h, AC28 18h01, ME1a 14h06을 함께 학습했습니다(180 epochs, best epoch 136). 개별 모델과 동일한 12k 하드 약한 라벨 설정에서 비교하면 실행별 방향이 일관되지 않습니다.
| 평가 실행 | 개별 AP / IoU | 공동 AP / IoU | 변화 |
|---|---|---|---|
| AC28 16h | 0.3849 / 0.2000 | 0.1474 / 0.1452 | 낮아짐 |
| AC28 18h01 | 0.4455 / 0.1364 | 0.6714 / 0.4651 | 높아짐 |
| ME1a 14h06 | 0.6292 / 0.4762 | 0.4765 / 0.0535 | 낮아짐 |
공동 학습은 세 seen 실행 중 AC28 18h01에서만 IoU를 개선했습니다. 따라서 이 표만으로 공동 학습이 개별 예측성을 전반적으로 개선한다고 결론 낼 수 없습니다.
Leave-one-run-out
| 평가 실행 | 학습 실행 | AP | IoU@0.5 | Dice@0.5 |
|---|---|---|---|---|
| AC28 16h | AC28 18h01 + ME1a | 0.0047 | 0.0000 | 0.0000 |
| AC28 18h01 | AC28 16h + ME1a | 0.0046 | 0.0000 | 0.0000 |
| ME1a 14h06 | AC28 16h + AC28 18h01 | 0.0010 | 0.0000 | 0.0000 |
4. 다른 모델 계열
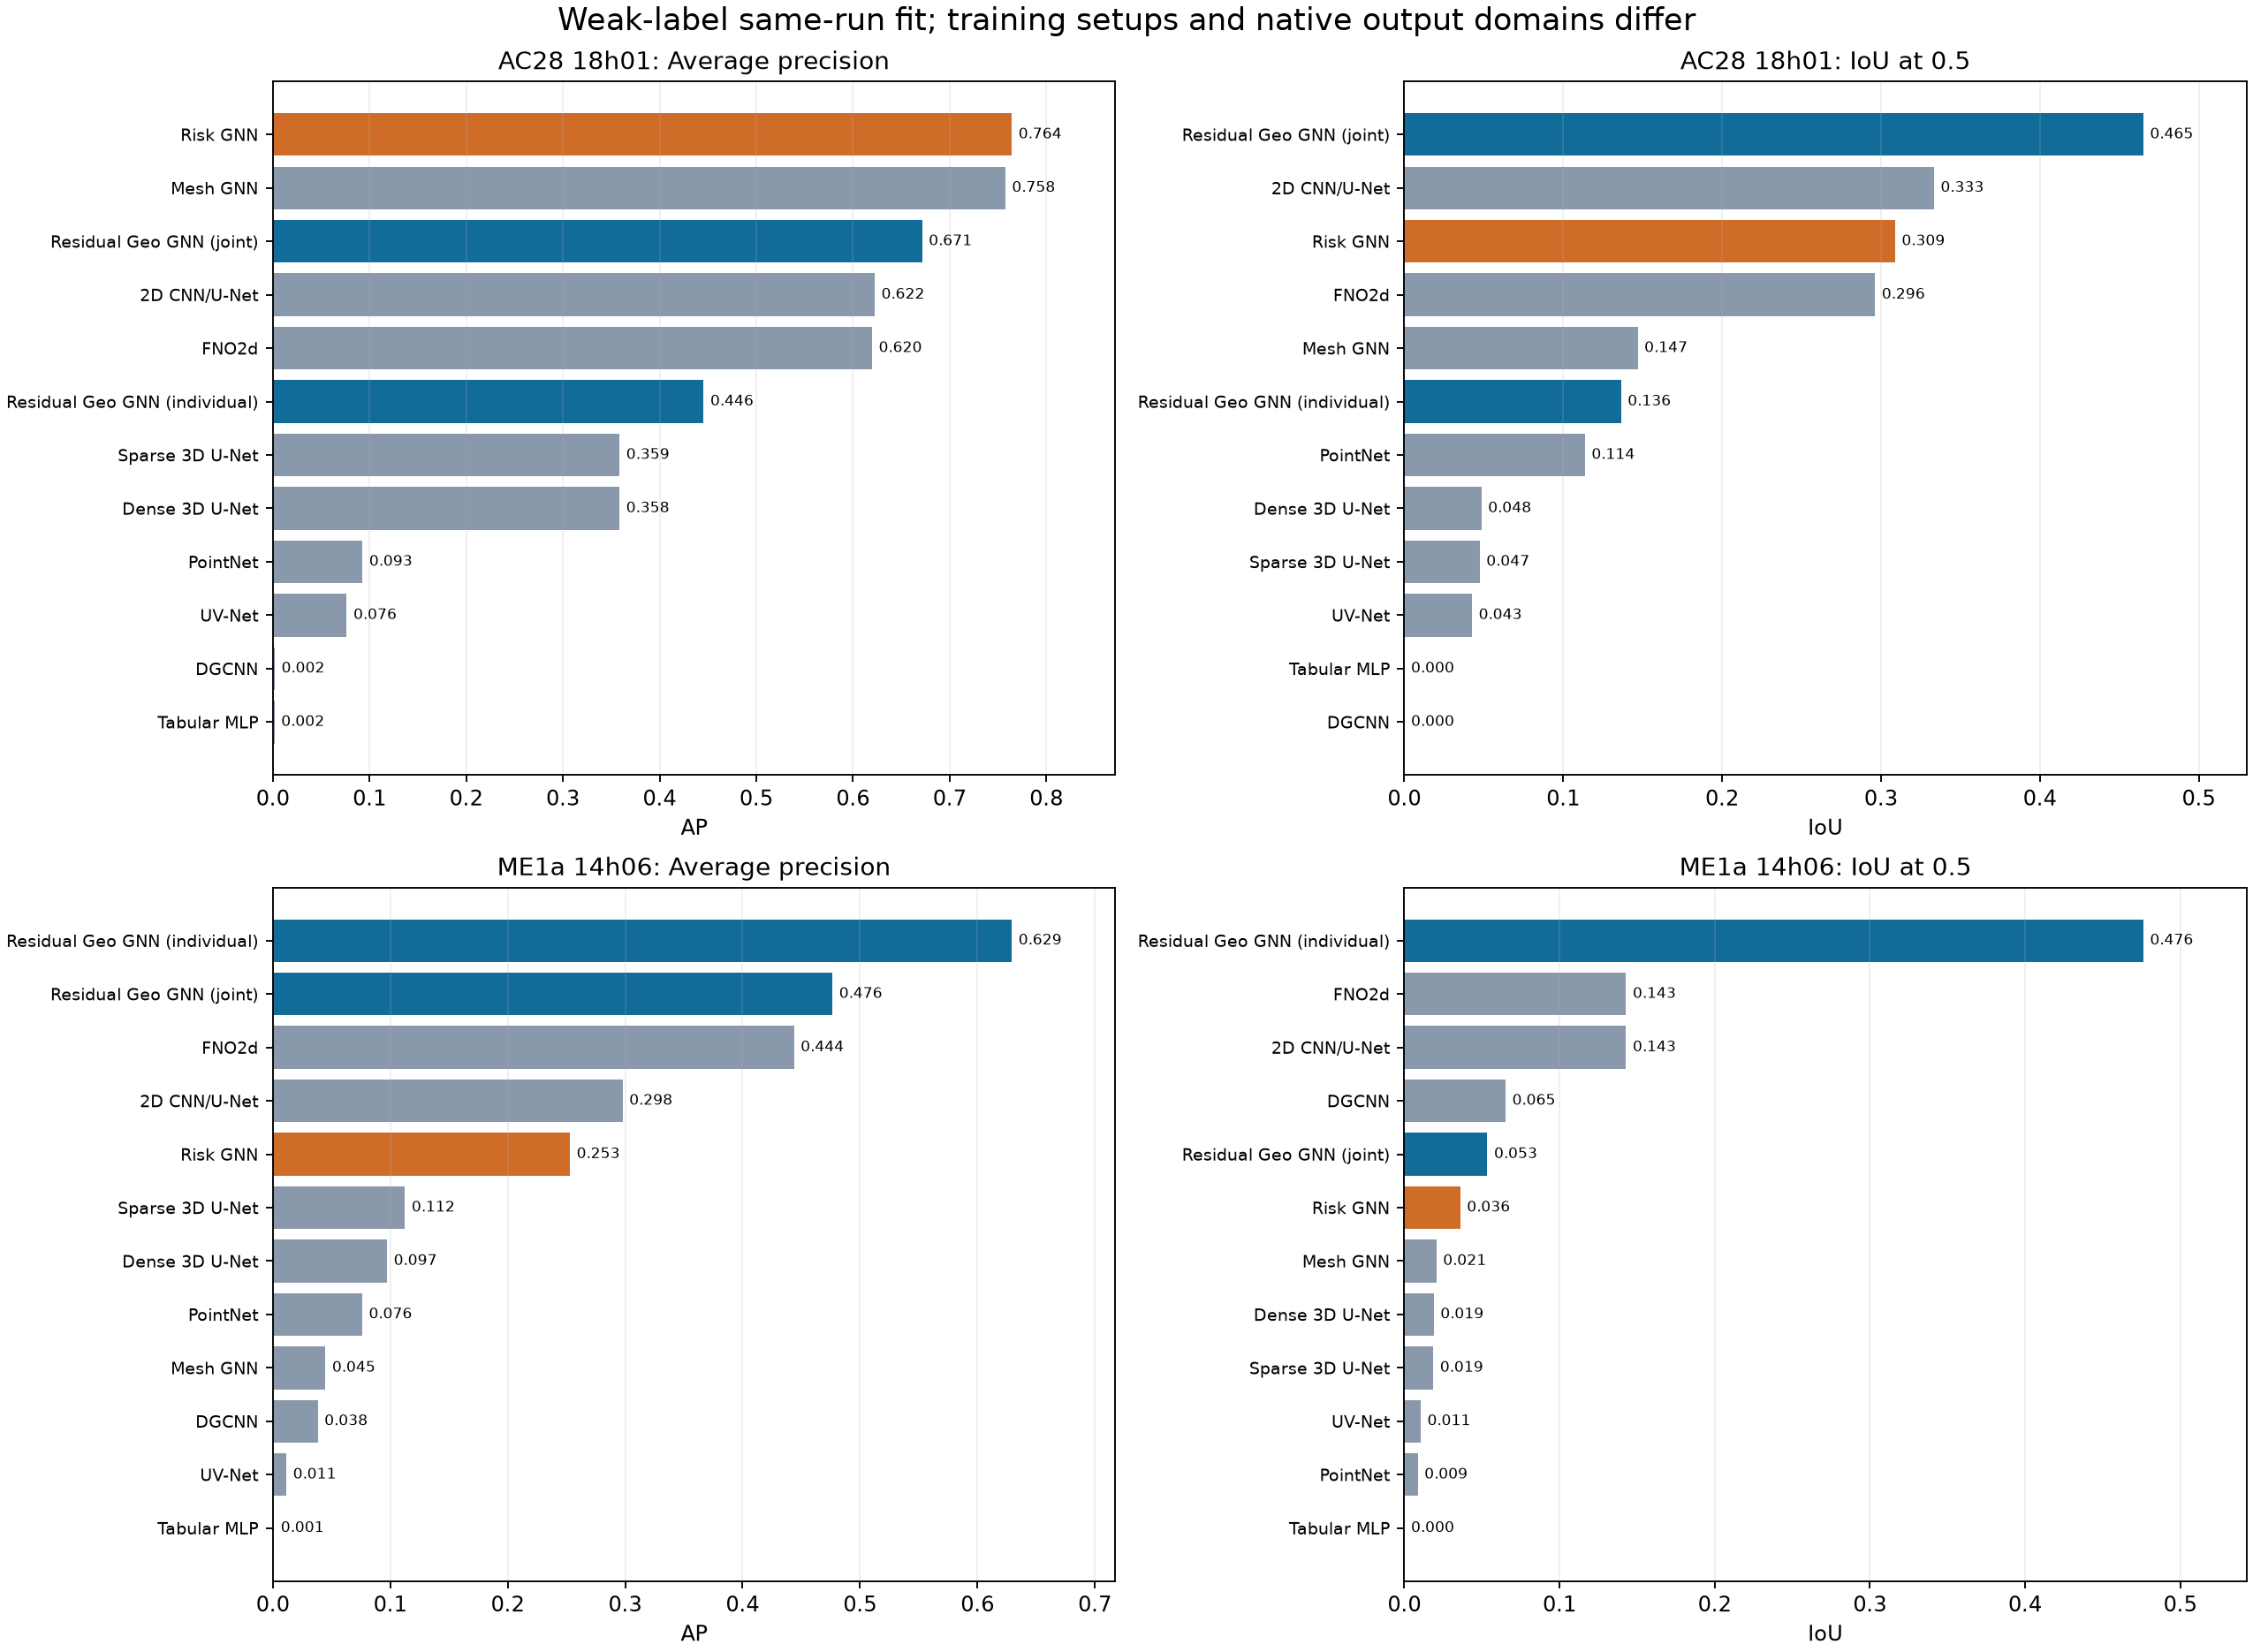
공통 CAD 위험장 비교에는 10개 기존 계열과 최적화 GNN을 포함합니다. 아래는 각 제품의 기존 개별 baseline 결과이며, 입력 해상도·학습 epoch·훈련 실행이 동일하지 않아 모델간 절대 순위로 읽어서는 안 됩니다.
| 모델 | AC28 AP / IoU | ME1a AP / IoU | 비고 |
|---|---|---|---|
| 2D CNN/U-Net | 0.6225 / 0.3333 | 0.2978 / 0.1429 | 기존 128 이미지 baseline |
| FNO2d | 0.6197 / 0.2963 | 0.4438 / 0.1429 | 기존 2D baseline |
| Dense 3D U-Net | 0.3585 / 0.0485 | 0.0973 / 0.0190 | 기존 32 복셀 baseline |
| Sparse 3D U-Net | 0.3586 / 0.0474 | 0.1125 / 0.0187 | 환경에서 MinkowskiEngine backend 이용 불가 |
| PointNet | 0.0927 / 0.1136 | 0.0761 / 0.0086 | 점군 baseline |
| DGCNN | 0.0020 / 0.0000 | 0.0382 / 0.0652 | 점군 baseline |
| Mesh GNN | 0.7575 / 0.1469 | 0.0448 / 0.0206 | 그래프 baseline |
| Risk GNN | 0.7643 / 0.3088 | 0.2530 / 0.0360 | AC28은 두 run 학습 |
| UV-Net | 0.0765 / 0.0426 | 0.0115 / 0.0105 | B-Rep baseline |
| Tabular MLP | 0.0018 / 0.0000 | 0.0011 / 0.0000 | CAD 전역 위험장 한계 |
5. 시각 산출물·코드 참조
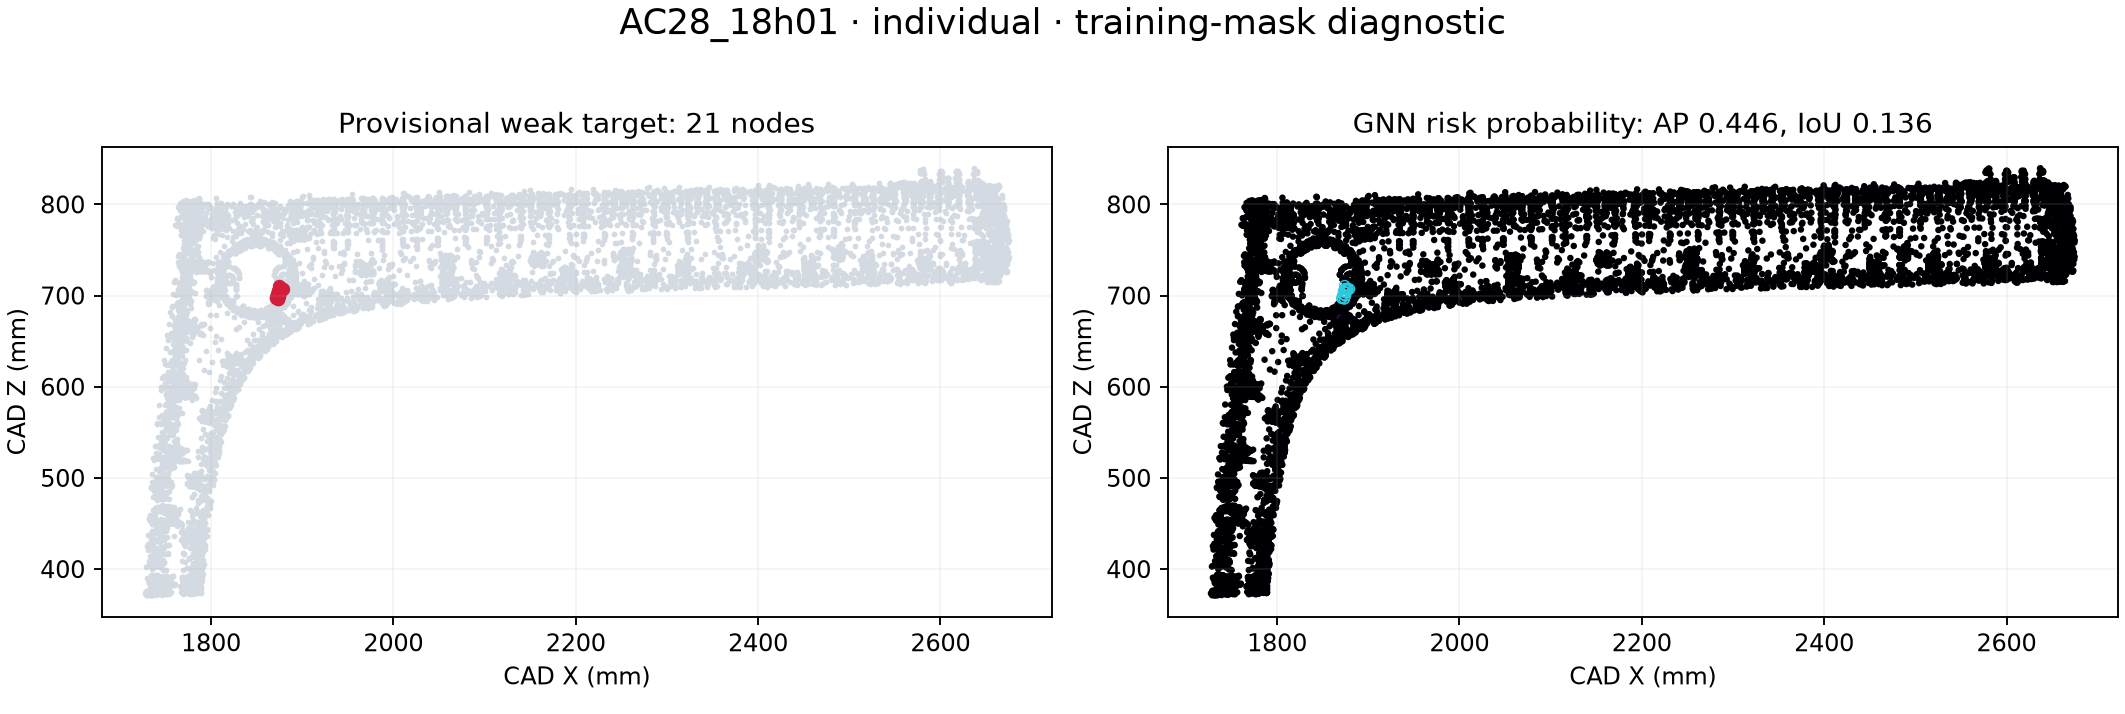
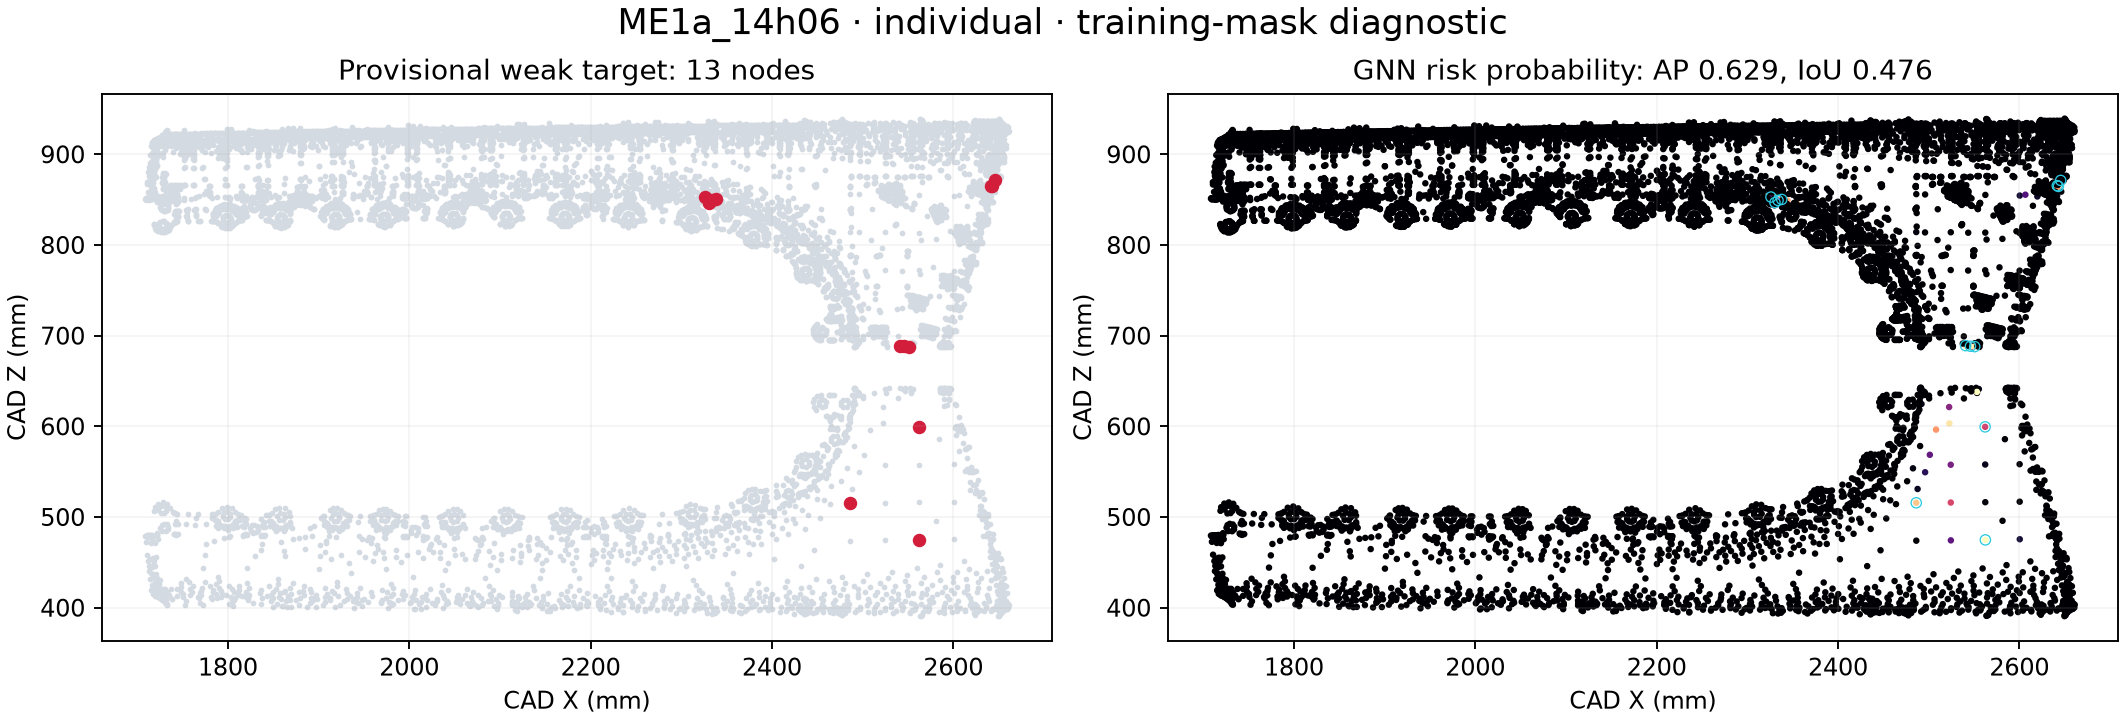
수치 원본: AC28 16h report.json · AC28 18h01 report.json · ME1a report.json · 공동 report.json · held-out report.json · 모델 비교 CSV.